LLM Hub
Uso e custo da inteligência artificial no seu tenant.
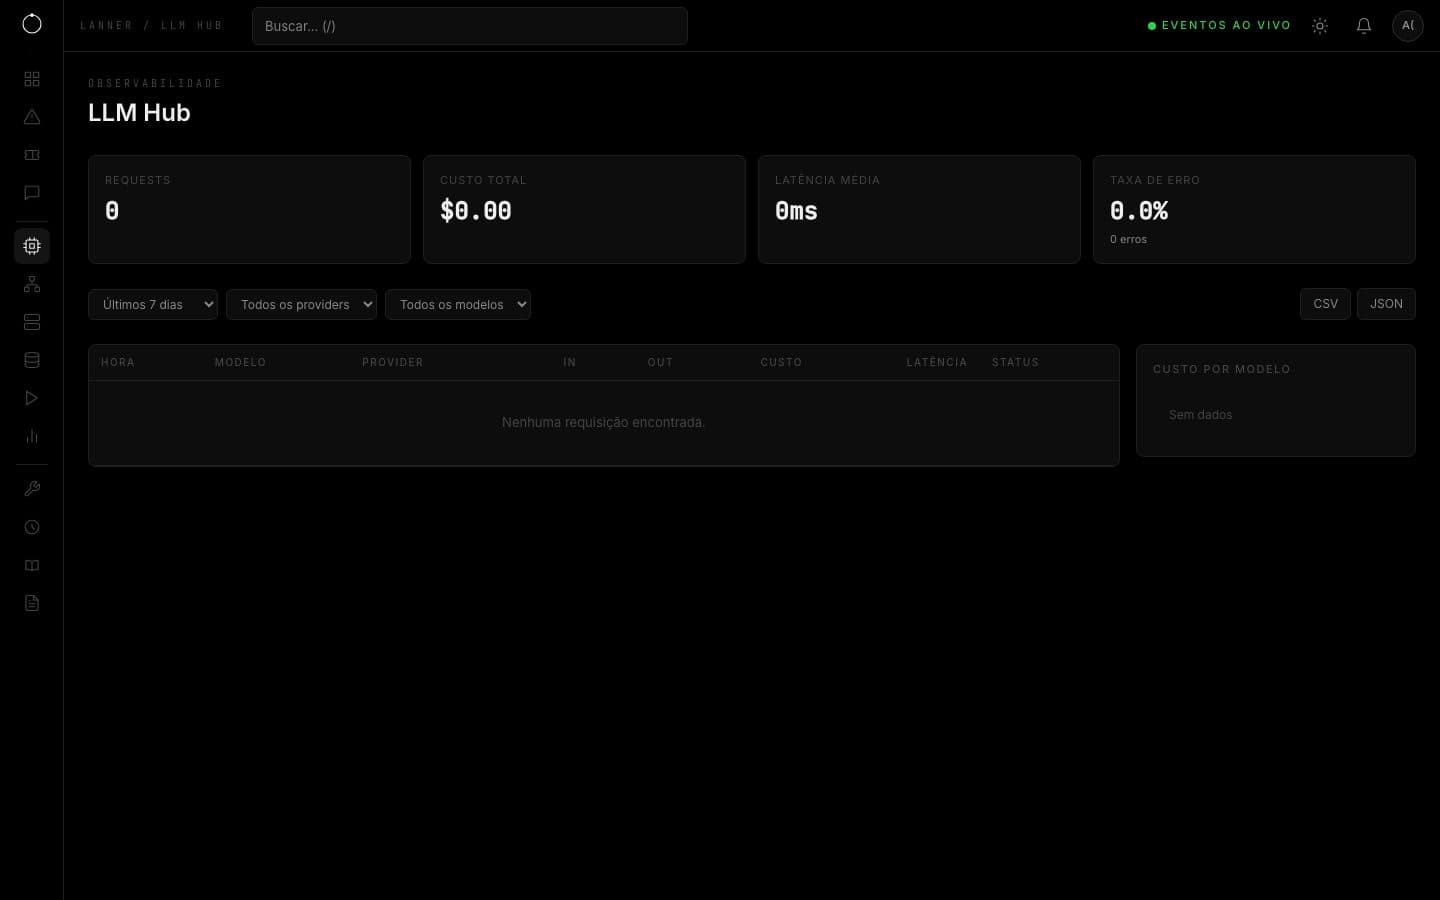
LLM Hub.
- Indicadores: requisições, custo total, latência média e taxa de erro.
- Filtros: período (24h, 7 dias, 30 dias, tudo), provedor, modelo e investigação. O modo ao vivo mostra as chamadas em tempo real.
- Detalhe: cada chamada a um modelo de IA registra provedor, modelo, atividade (investigação, chat, validação etc.), tokens de entrada e de saída, tokens de cache, custo estimado (calculado e gravado no momento da chamada), latência, motivo de encerramento (resposta completa, limite de tokens, chamada de ferramenta) e status, além da investigação e da iteração de origem. O painel lateral mostra o custo por modelo.
- Exportar: botões CSV e JSON.
Exportar dados
As chamadas de IA podem ser exportadas em CSV e JSON. As métricas da plataforma ficam disponíveis no formato Prometheus e os traces em OpenTelemetry (OTLP), para ferramentas analíticas externas.